개요
그림을 그리다 레퍼런스가 필요하면 GPT에게 물어보곤 했다. 이 기법이 쓰인 그림을 찾아달라거나, 참고할 만한 작가를 모아달라는 식이었다.
그런데 받아 보면 내가 말한 조건과 다른 그림이 오거나, 그림 없이 설명만 오는 경우가 많았다. 무엇보다 가져온 그림이 내가 보고 배우고 싶은 그림이 아닌 경우가 많았다. 설명이 이론적으로 맞아도 그림이 마음에 안 들면 참고할 마음이 안 생긴다.
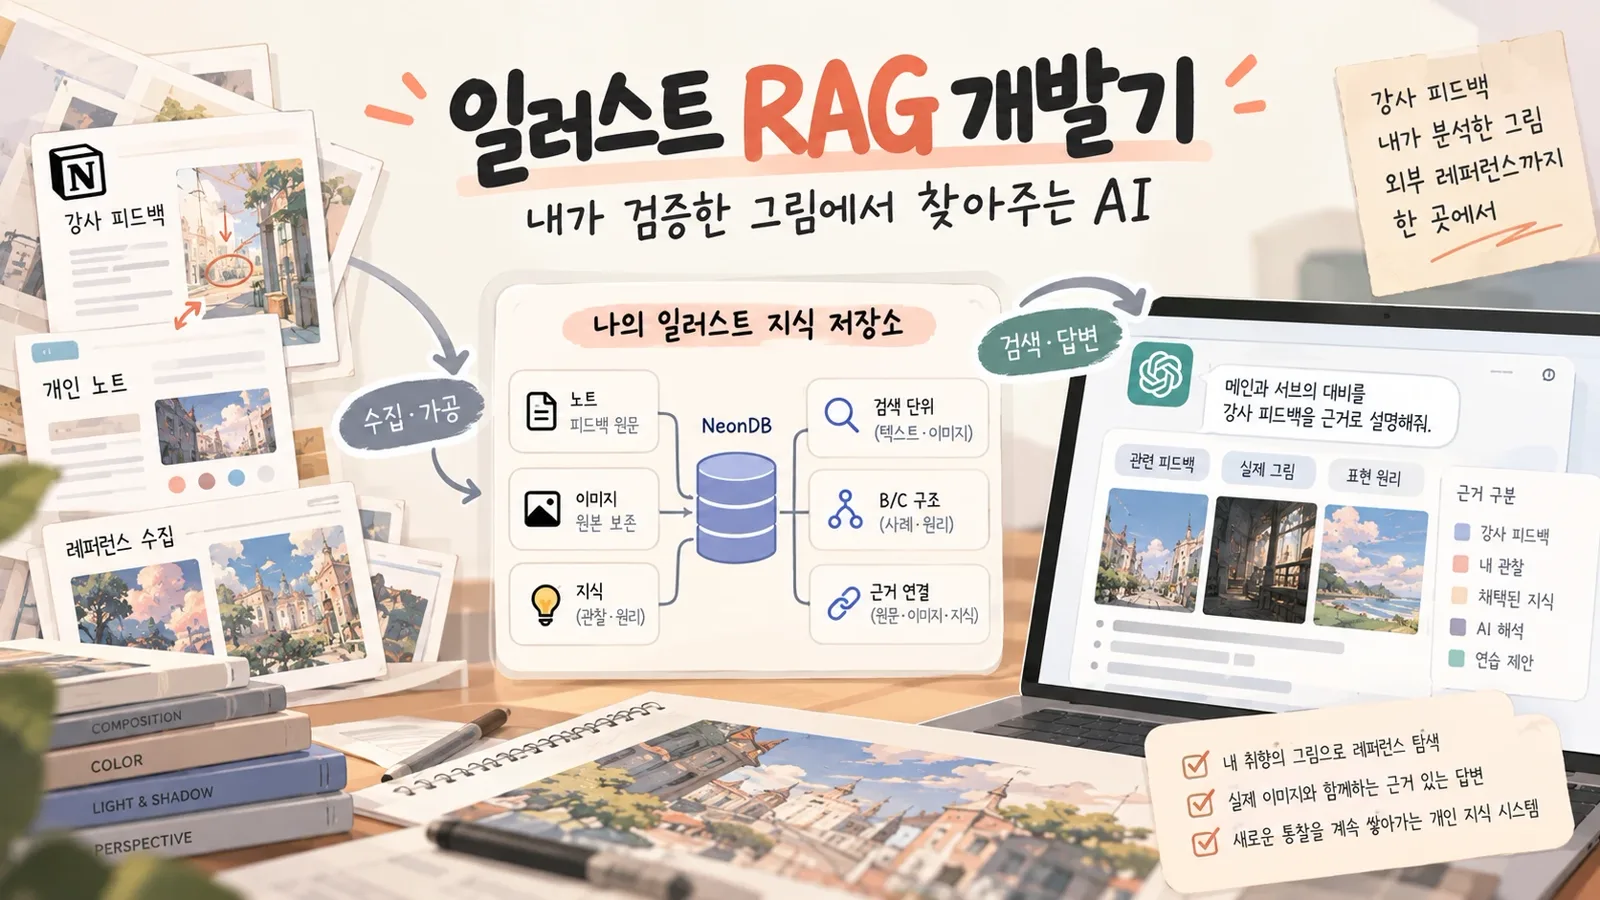
그래서 내가 좋다고 고른 그림과 거기서 배운 걸 쌓아두고, 필요할 때 AI가 그걸 꺼내주는 시스템이 있으면 좋겠다고 생각했다. 마침 SSAFY에서 RAG 프로젝트 과제가 나와서 도메인을 일러스트로 잡았다.
이 글은 그 과제 버전의 기록이다. RAG를 처음 직접 만들어 본다면 데이터 확보, 비교 질문 검색, 문장과 그림 연결에서 어디가 막히는지 미리 볼 수 있을 거다. 적어보겠다!
처음 구조는 검색 하나, 생성 하나
RAG(Retrieval-Augmented Generation)는 질문이 들어오면 먼저 관련 문서를 검색하고, 그 문서를 LLM 입력에 같이 넣어 답하게 하는 방식이다. 모델이 학습하지 않은 지식을 모델 밖에 두고 그때그때 꺼내 쓴다.
과제 버전의 기획은 “그리다 막힌 고민을 입력하면 관련 기법을 찾아 수정 방향을 제안”하는 RAG였다. 예를 들어 “러프가 평면적으로 보이는데 공간감을 더하고 싶다”고 넣으면 관련 기법과 근거, 수정 대안을 보여준다.
| 구성 | 사용한 것 |
|---|---|
| 화면 | Streamlit |
| 흐름 | LangGraph — 검색 노드, 생성 노드 두 개 |
| 저장 | ChromaDB — 기법 메타데이터와 설명 문서를 컬렉션 분리 |
| 임베딩 | 로컬 임베딩 모델 |
| 답변 생성 | SSAFY 제공 GMS |
구조는 단순했고, 실제로 먼저 막힌 곳도 검색 로직이 아니었다.
100개는 과제 조건이었고, 엄격한 승인은 내 조건이었다
과제 요구사항에 기법 항목 약 100건을 확보하라는 조건이 있었다.
처음에는 출처, 이용 조건, 검증 상태를 하나하나 엄격하게 관리하면서 모았다. 그랬더니 쓸 수 있는 항목이 34개에서 멈췄다. 요구사항을 다시 읽어 보니 과제가 요구한 건 항목 수였고, 엄격한 승인 조건은 내가 스스로 얹은 기준이었다. 둘을 같은 조건으로 보고 있었던 거다.
그래서 공개 자료로 수집 범위를 넓혔다. 영어 위키백과에서 기법 문서를 가져와 관련 문단을 고르고, LLM으로 한국어 설명 초안을 만드는 방식이다. 여기서도 문제가 줄줄이 나왔다.
- Wikimedia API를 문서마다 따로 호출하니 HTTP 429(요청 과다)가 반복됐다. 여러 문서를 한 번에 조회하는 배치 방식으로 바꿨다.
- 이름이 비슷한 기법이 같은 문서로 리다이렉트돼서 중복 수집됐다.
- 디지털 일러스트용 데이터에 유화·수채화처럼 실물 매체에서만 쓰는 기법이 섞였다.
기법마다 근거로서의 역할과 적용 매체를 구분하고, 맞지 않는 건 보류해서 적격 항목 103개를 확보했다. 다만 103개 모두 전문가 검증을 거친 건 아니다. LLM이 만든 설명 초안을 실제로 믿고 쓸 수 있는 지식으로 만드는 일은 따로 남았다.
비교 질문은 한 문장으로 검색하면 한쪽이 묻힌다
데이터가 모이고 검색 품질을 보기 시작했을 때 가장 대표적인 실패는 두 기법을 비교하는 질문이었다.
“강한 명암 대비와 대기 원근법을 비교하고 싶다”고 검색하면 Top-5 중 세 자리를 키아로스쿠로(강한 명암 대비 기법) 청크가 차지했다. 대기 원근법은 혼자 검색하면 1위인데, 두 개념을 합친 질문에서는 12위까지 밀렸다.
원인은 두 가지가 겹쳐 있었다.
- 긴 문서 하나가 여러 청크로 쪼개져 검색 결과 자리를 독점했다.
- 서로 다른 개념을 한 문장으로 임베딩하면 벡터가 한쪽 개념 쪽으로 기운다.
그래서 검색 결과를 청크가 아니라 항목 단위로 중복 제거하고, 비교 질문은 개념마다 따로 검색한 뒤 병합하도록 바꿨다.
그런데 LLM이 검색문을 여러 개 만들도록 프롬프트를 바꾸자, 이번엔 주 검색문을 빈 값으로 돌려주는 경우가 생겼다. LLM이 늘 올바른 형식을 낼 거라고 기대하는 대신, 입력이 비면 코드에서 정해진 방식으로 처리하게 했다.
수정 뒤에 특정 질문이 잘못 분류되는 걸 보고 회귀인 줄 알았던 일도 있었다. 이전 프롬프트와 새 프롬프트를 같은 입력으로 여러 번 돌려 보니, 원래부터 있던 문제였다. 이전 실행에서는 LLM이 우연히 맞게 답해서 안 보였을 뿐이다. 이 뒤로는 프롬프트를 한 번 돌린 결과를 믿지 않고, 실제로 실패했던 사례를 회귀 테스트로 만들어 반복 실행했다.
문장이 관련 있다고 그 그림이 근거인 건 아니다
텍스트 RAG는 관련 문장을 찾아 답할 수는 있지만, 그 답에 맞는 그림까지 골라주지는 않는다.
강사 피드백에는 원본 그림, 첨삭 이미지, 설명 이미지가 섞여 있었다. 어떤 문장이 어떤 이미지를 가리키는지 대응 관계가 따로 필요했다.
처음엔 AI에게 자동으로 연결하게 했다. 사람이 확인한 작은 표본에서 설명 이미지와 문장의 자동 연결은 11개 중 3개만 맞았다. 틀린 연결을 고치느니 사람이 빠르게 직접 연결하는 도구가 낫다고 판단해서, 이미지와 문장을 선으로 잇는 편집기를 만들고 키보드로 빠르게 연결하는 기능도 붙였다.
이 편집기에서도 문제가 있었다.
- CSS
sticky가 동작하지 않았다. - 이미지 노드를 추가하면 저장해 둔 연결이 사라졌다. 저장본의 노드 목록 해시가 완전히 같을 때만 복원하도록 짜 둔 게 원인이었다. 노드가 하나만 늘어도 해시가 달라지니 복원을 포기한 거다. 연결 대상이 그대로 있으면 복원하도록 조건을 바꿨다.
문서가 관련 있다는 것과, 특정 이미지가 그 문서의 주장을 직접 뒷받침한다는 것은 다르다.
RAG 없는 답이 더 풍부했다
마지막으로 RAG를 쓴 답과 일반 LLM 답을 나란히 비교했다.
RAG를 쓰지 않은 답이 더 풍부하고 실용적인 경우가 있었다. 대신 그 답에는 자료로 확인되지 않은 일반론이나 구체적인 수치가 섞였다. RAG는 주어진 근거에 충실한 만큼, 자료가 부족하면 내놓을 수 있는 대안도 좁았다.
일반 LLM이 이미 잘하는 설명을 RAG가 다시 하는 거라면 굳이 RAG를 쓸 이유가 없다. 이 RAG에는 내가 믿는 자료와 실제 그림을 근거로 답한다는 차별점이 있어야 했다.
제출용 RAG와 내가 쓰고 싶은 도구
그 문제를 과제 안에서 깊게 파기는 어려웠다. 정해진 기술 요건과 최소 기능이 있었고, 제공된 GMS API를 써야 했고, 기간도 빠듯했다. 진행될수록 내가 실제로 필요한 기능보다 제출 요건을 맞추는 데 시간이 더 들어갔다.
그래도 데이터 수집, 출처 검증, 검색 품질, 이미지 매핑까지 RAG를 만들 때 부딪히는 문제를 한 바퀴 돌아본 건 남았다. 다만 제출용 RAG와 내가 그림 공부하면서 쓰고 싶은 도구는 같지 않았다. 그래서 과제를 제출한 뒤에는 이 설계를 그대로 키우지 않고, 내가 정말 쓰고 싶은 시스템이 뭔지부터 다시 기획하기로 했다.
소감
내가 원하는 것과 요구사항간의 괴리감을 생각하지 않고 기획을 밀어붙인게 너무나도 바보같았다.. 조금 더 기획 시간을 오래 가져볼 거 그랬다ㅠ