개요
질문 하나에 꼭 필요한 이미지가 검색 후보 21위에 있었다. 다른 질문에서는 11위였다. 검색은 동작했고, 이미지도 DB에 있었고, 그런데도 답에는 안 나왔다.
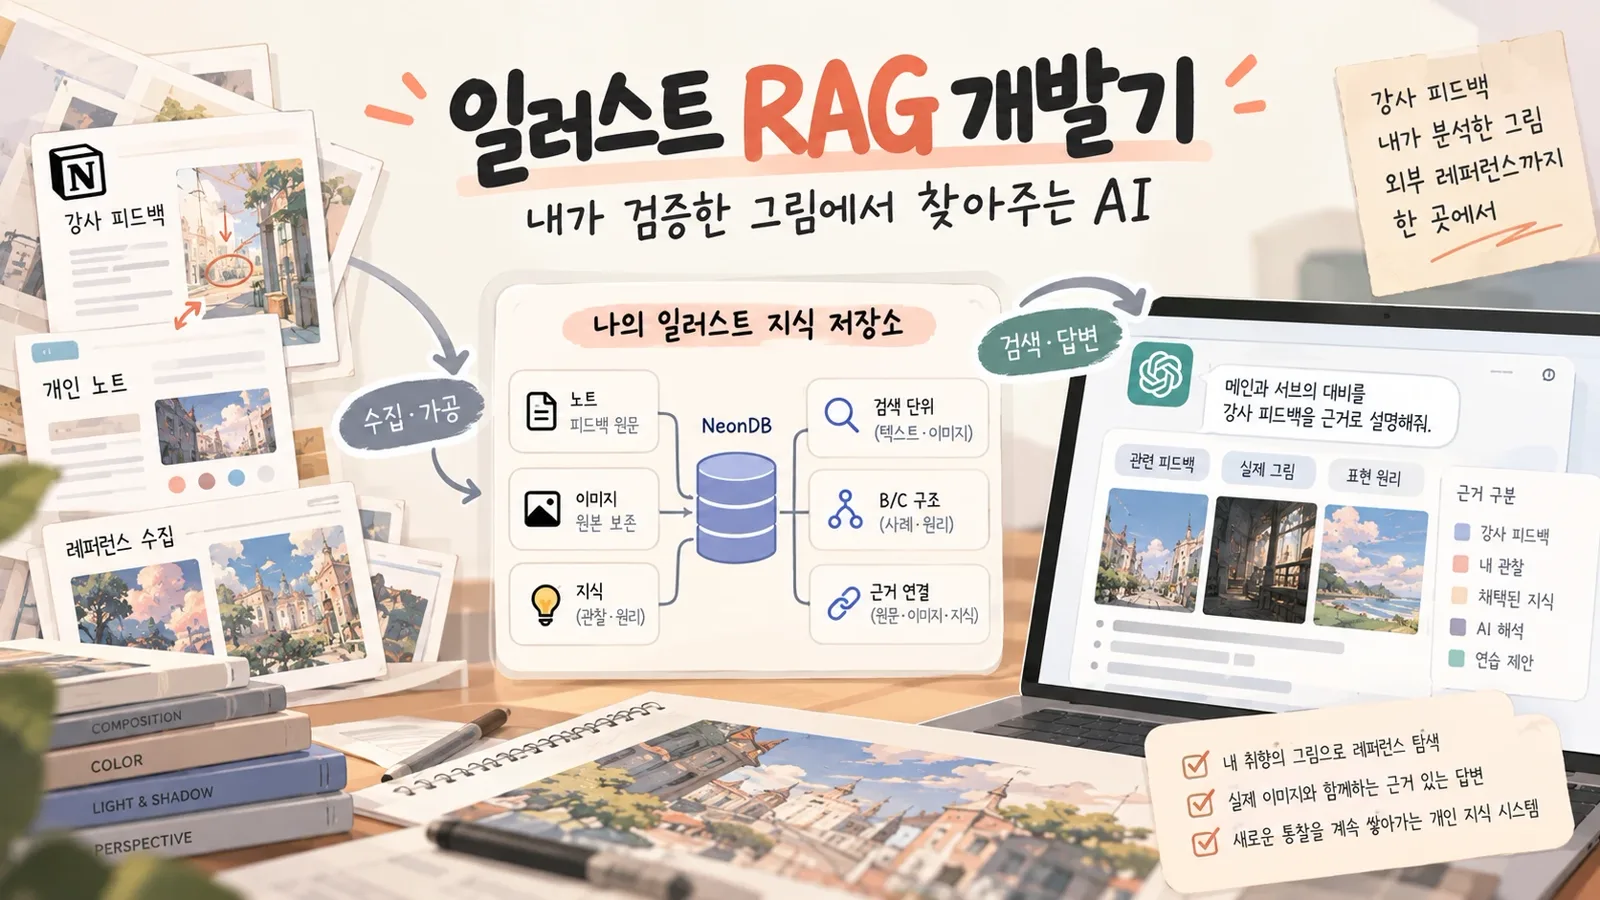
앞 글에서 이 시스템의 목표를 “좋아하는 그림과 거기서 배운 걸 이미지 근거와 함께 쌓아두고 다시 꺼내 쓰는 개인 지식 저장소”로 다시 정했다. 이 글은 그걸 실제로 만들고 써 본 기록이다. RAG를 만들어 놓고 “검색은 되는데 왜 쓸모가 없지?” 싶은 상태라면, 검색 적중과 실사용을 어떻게 나눠 봤는지, 그리고 매번 개발 도구를 여는 대신 MCP로 ChatGPT에 붙인 과정을 볼 수 있을 거다.
LLM은 대화를, 하네스는 검색·저장·검증을
별도 AI 앱은 만들지 않았다. 대화와 이미지 해석은 ChatGPT나 Claude 같은 LLM 서비스가 맡고, 내가 만든 Python 하네스는 검색·저장·검증만 한다. LLM은 Skill에 적힌 절차를 따라 하네스를 호출한다.
여기서 하나 구분할 게 있다. Skill은 작업 순서를 적은 문서다. Skill이 있다고 LLM이 DB를 조회하거나 로컬 Python을 실행할 수 있게 되지는 않는다. 실제로 도구를 실행할 환경과 연결은 따로 만들어야 했고, 이게 뒤에서 MCP로 이어진다.
NeonDB에 원문, 이미지, 지식, 근거를 따로 저장
저장소는 NeonDB(서버리스 Postgres)로 잡았다. Notion에서 가져온 원문과 이미지, 가공한 지식, 근거 관계, 검색 단위를 각각 다른 테이블에 둔다. 이미지는 private Storage에 두고 SHA-256 해시와 파일 크기로 원본이 그대로인지 확인한다.
여기서 세 가지를 서로 다른 단계로 다뤘다.
| 단계 | 확인하는 것 | 확인하지 않는 것 |
|---|---|---|
| 원본 보존 | DB에 이미지 경로와 설명이 있다 | AI가 그 그림을 봤는지 |
| 무결성 검사 | 복원한 파일이 원본과 같다 | 그 그림에 대한 해석이 맞는지 |
| 시각적 관찰 | AI가 실제로 열어서 봤다 | — |
DB에 경로가 있다고 AI가 그림을 봤다고 칠 수 없고, 파일을 무사히 복원했다고 해석까지 맞다고 칠 수도 없다.
검색은 의미 기반 검색과 문자 단위 TF-IDF를 함께 돌리고 RRF(Reciprocal Rank Fusion, 각 검색기의 순위를 역수로 더해 합치는 방식)로 합쳤다. 지식뿐 아니라 원문과 이미지 주변 맥락도 검색 대상이다. 검토 중인 초안 지식이 채택된 지식처럼 쓰이지 않도록, 기본 검색은 채택된 것만 보고 초안은 명시적으로 켜야 포함된다.
찾았다와 쓸모 있다는 다르다
검색이 돌아가기 시작하고 직접 써 보니 가장 크게 걸린 게 이거였다. 개요의 21위, 11위가 그 예다. 조건이 여러 개 붙은 질문에서는 일부 조건에 맞는 자료만 올라오기도 했다. 텍스트가 비슷하다고 그 이미지가 질문에 맞는 그림인 건 아니었다.
그래서 “검색하기 전에 LLM이 질문을 1차 가공하는 게 나은가?”를 따져 봤다. 질문 원문은 그대로 두고, 표현 목적·핵심 시각 조건·필요한 자료 유형·하위 질문을 뽑아 검색에 쓰는 방식이다. 검색에 유리하게 문장만 바꿔 쓰는 쿼리 재작성과는 다르다.
다만 이것만으로 다 풀리지는 않는다. 실패를 뜯어 보면 원인이 세 군데로 나뉘었다.
- 후보 형성: 필요한 자료가 검색 후보에 아예 안 들어왔다.
- 후보 선택: 후보에는 있었는데 중복 결과에 밀렸다.
- 자료 연결: 관련 고찰은 찾았는데 그 작품의 실제 이미지를 못 가져왔다.
질문을 잘 해석해도 1번이 안 되면 소용없고, 3번은 검색 뒤의 문제다. 그래서 검색 전 질문 분석, 후보 확장, 검색 후 적합성 확인을 각각 따로 실험했다.
10월 27일, 데이터는 쌓였지만
1차 구현을 검토한 시점의 저장소는 이랬다.
| 항목 | 수 |
|---|---|
| 출처 | 88 |
| 저장 이미지 | 503 |
| 검색 단위 | 1,244 |
| 지식 | 118 (채택 13 / 초안 104 / 대체됨 1) |
Notion 수집과 원본 보존, 하이브리드 검색, 지식 가공과 검증, 내 그림 피드백, 외부 레퍼런스 등록까지 흐름은 구현돼 있었다. 그런데 지식 118개 중 채택된 건 13개뿐이다. 학습카드 103개는 같은 에이전트가 텍스트만 보고 묶은 해석이었고, 블라인드 평가도 질문 5개 표본이었다.
그 작은 평가에서 단순 검색 목록보다 근거를 종합해 원리와 판단 기준을 설명하는 답이 더 낫다는 신호는 있었다. 하지만 처음 보는 질문들에서 안정적으로 동작한다고 말하기엔 표본이 작았다. 이미지가 500장 넘게 있어도, 원하는 조건에 맞는 그림을 찾아 보여주지 못하면 이 RAG를 만든 이유가 없다. 이때부터 “구현됐다”와 “쓸모 있다”를 따로 평가했다.
느리면 안 쓰게 된다
개인용 도구는 정확도만큼 편해야 한다. 그런데 기존 실행 경로는 매번 전체 데이터를 다시 조회하고 임베딩 모델을 새로 준비했다.
그래서 로컬 데이터 미러와 임베딩 캐시를 재사용하게 바꿨다. 조건은 DB 체크섬과 로컬 미러가 일치할 때만이다. 다르면 검색을 멈추고 동기화부터 하게 했다. 오래된 데이터로 조용히 답하는 것보다 멈추는 게 낫다.
기록상 cold index 초기화는 약 196초, 같은 질문을 캐시로 다시 검색한 건 약 3.21초였다. 다만 두 수치는 재는 범위가 달라서 “몇 배 빨라졌다”로 비교할 수 없다. 이미지 다운로드와 LLM 답변 생성 시간도 빠져 있다. 확실한 건 매번 전체 데이터와 모델을 새로 준비하지 않도록 실행 경로를 나눴다는 것까지다.
Codex 대신 평소 쓰던 ChatGPT에서
그림 공부하다가 예전에 배운 걸 찾고 싶을 때마다 개발 도구를 열어야 하면 손이 안 간다. 평소 쓰는 ChatGPT에서 자연어로 묻고, 그 뒤에서 하네스가 돌게 하고 싶었다.
그래서 MCP(Model Context Protocol)를 붙였다. MCP는 LLM 클라이언트가 외부 도구를 호출하는 규약이다. 검색 엔진을 새로 만든 게 아니라 기존 Python 하네스를 MCP 도구로 감쌌다.
사용자
  ↓
ChatGPT + Skill
  ↕ MCP / Private Tunnel
로컬 Python 하네스
  ↕
Neon DB / Private Storage
ChatGPT는 질문을 해석하고, 도구를 호출하고, 실제 그림을 보고 답한다. 하네스는 검색 실행, 원본 이미지 복원, 근거 ID와 상태 검증, 실행 기록을 맡는다. 답변과 이미지 해석을 위한 LLM API 호출은 따로 추가하지 않는 방향으로 짰다. ChatGPT 구독이나 DB·Storage·Tunnel 운영 비용까지 없어지는 건 아니다.
MCP를 붙이며 생긴 일
검색은 기존 함수를 그대로 쓰고, ChatGPT용으로 도구를 몇 개 더 만들었다. 실행 상태 조회, 이미지 원본 요청, 답변 제출이다.
- 같은 작업이 두 번 제출되거나 오래된 실행 결과가 반영되지 않도록 실행 ID와 교환 상태를 확인한다.
- 이미지는 크기 제한을 두고 넘기고, 원본을 열지 못했으면 검증된 이미지로 치지 않는다.
실행 환경 쪽에서는 Windows 문자 인코딩, 임시 폴더 권한, 네트워크 연결 실패가 차례로 나왔다. MCP SDK의 비동기 검증이 멈추는 일도 있었는데, 따라가 보니 Windows 이벤트 루프와 소켓 생성 단계에서 대기하고 있었다. 그래서 일반 회귀 테스트와 실제 stdio MCP 검증을 분리했다.
10월 28일 기준으로 Python 테스트 161개와 내부 Node 테스트 13개가 통과했고, MCP 프로토콜 수준에서 초기화와 도구 호출을 확인했다. 여기까지가 로컬 어댑터 이야기다. 실제 계정의 Private Tunnel 연결, ChatGPT가 이미지를 제대로 보는지, 사용자가 첨부한 그림이 하네스까지 가는 경로는 이 테스트 범위 밖이다.
소감
처음 RAG를 만들 때는 관련 문서를 잘 찾고 근거 있는 답을 내면 된다고 생각했다. 직접 써 보니 질문에 맞는 실제 그림을 찾아야 했고, 그 그림에서 본 사실과 AI의 해석을 나눠야 했고, 예전 통찰이 어떤 이미지와 원문에서 나왔는지 되짚을 수 있어야 했다… 만들고 이제부터 실사용을 해가며 계속해서 보완해봐야할 것 같다